Shihanmax
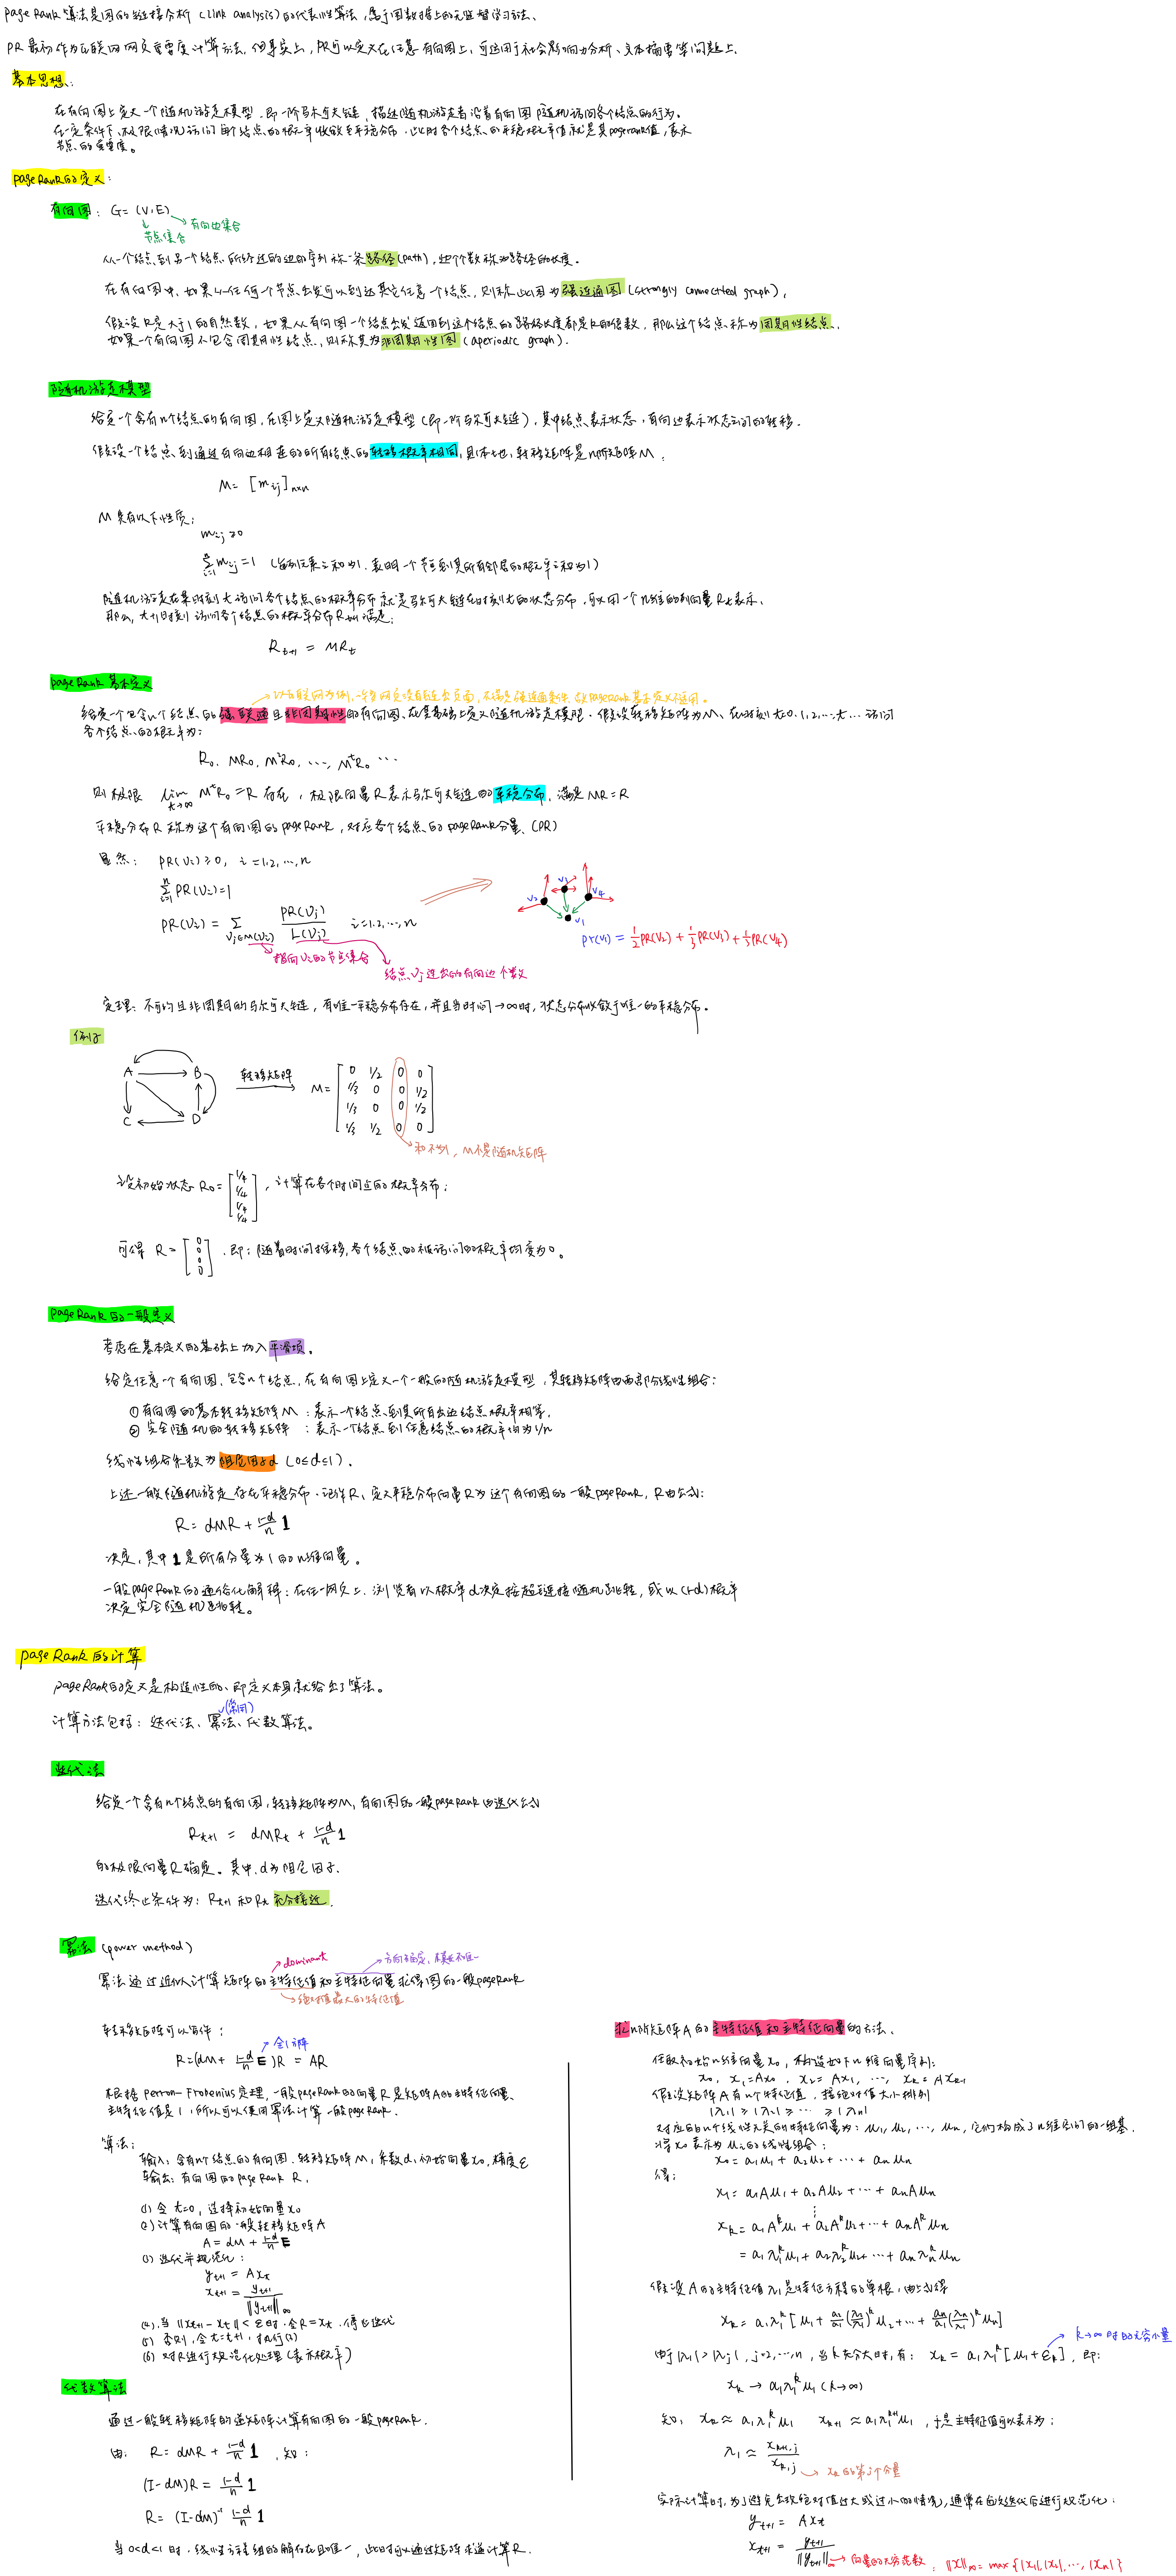
二十一、PageRank算法
统计学习方法:PageRank算法
一、引言
PageRank是Google搜索引擎的核心算法之一,由Larry Page和Sergey Brin在1990年代末期开发。该算法通过分析网页之间的链接关系,为每个网页分配一个权重值,从而确定网页的重要性。
PageRank的核心思想是:一个网页的重要性不仅取决于有多少网页链接到它,还取决于这些链接来源网页本身的重要性。这可以类比于学术论文的引用机制——一篇被重要论文引用的论文往往也更重要。
二、马尔可夫链基础
2.1 随机过程与马尔可夫链
随机过程是一族依赖于参数$t$的随机变量${X(t), t \in T}$,其中$T$是参数集合。当$T$是可数集时,称为离散时间随机过程;当$T$是连续区间时,称为连续时间随机过程。
马尔可夫链是一种特殊的随机过程,具有”无记忆性”或”马尔可夫性质”。设${X_n, n \geq 0}$是一个随机过程,若对于任意$n$和状态序列$x_0, x_1, …, x_{n-1}, x_n$,有
\[P(X_n = x_n | X_0 = x_0, X_1 = x_1, ..., X_{n-1} = x_{n-1}) = P(X_n = x_n | X_{n-1} = x_{n-1})\]则称${X_n, n \geq 0}$为马尔可夫链。
2.2 转移概率与转移矩阵
| 从一个状态转移到另一个状态的概率称为转移概率,记作$p_{ij} = P(X_{n+1} = j | X_n = i)$。 |
对于有限状态的马尔可夫链,所有转移概率可以组成一个转移矩阵$M = [p_{ij}]_{m \times m}$,满足:
\[\sum_{j=1}^{m} p_{ij} = 1 \quad (i = 1, 2, ..., m)\]即矩阵每一行元素之和为1。
2.3 状态分布与 Chapman-Kolmogorov 方程
随机过程${X_n}$在时刻$n$的状态分布为$\pi_n = (\pi_{n1}, \pi_{n2}, …, \pi_{nm})$,其中$\pi_{ni}$表示在时刻$n$处于状态$i$的概率。
状态分布的演化遵循Chapman-Kolmogorov方程:
\[\pi_{n+1} = \pi_n M\]进而可得: \(\pi_{n+k} = \pi_n M^k\)
2.4 马尔可夫链的分类与极限性质
状态分类
- 常返态:从该状态出发,以概率1返回该状态
- 瞬过态:从该状态出发,有一定概率不再返回
- 正常返态:平均返回时间有限
- 零常返态:平均返回时间无限
极限性质
对于不可约、非周期的有限状态马尔可夫链,不论初始分布如何,当时间$n \to \infty$时,状态分布收敛于唯一的平稳分布$\pi^*$,满足:
\[\pi^* = \pi^* M\]这意味着$\pi^*$是转移矩阵$M$对应于特征值1的左特征向量。
三、PageRank算法原理
3.1 PageRank的基本思想
在互联网环境中,可以将每个网页视为一个节点,网页间的超链接视为有向边,这样整个互联网就构成了一个巨大的有向图。
PageRank的基本假设是:
- 一个网页被越多网页链接,它就越重要
- 一个重要的网页的链接比不重要的网页的链接更有价值
形式化地,假设有$n$个网页,第$i$个网页的PageRank值为$r_i$,则有:
\[r_i = \sum_{j \in B_i} \frac{r_j}{L(j)}\]其中$B_i$是链接到网页$i$的所有网页集合,$L(j)$是网页$j$的出链数量。
3.2 PageRank的数学模型
上述基本模型存在两个问题:
- 存在没有出链的网页(悬挂网页)
- 存在相互链接的网页形成孤立子图
为解决这些问题,引入了”随机跳转”机制。修改后的PageRank公式为:
\[r_i = \frac{1-d}{n} + d \sum_{j \in B_i} \frac{r_j}{L(j)}\]其中$d$是阻尼因子(通常取值为0.85),表示用户继续点击链接的概率,而$1-d$表示用户随机跳转到任意网页的概率。
3.3 矩阵形式的PageRank
将PageRank公式写成矩阵形式。定义:
- $\mathbf{r}$:PageRank向量,$\mathbf{r} = [r_1, r_2, …, r_n]^T$
- $\mathbf{M}$:原始链接矩阵,$M_{ij} = \frac{1}{L(j)}$如果网页$j$链接到网页$i$,否则为0
- $\mathbf{A}$:考虑悬挂网页的修正矩阵
最终的PageRank方程为:
\[\mathbf{r} = d \mathbf{A} \mathbf{r} + \frac{1-d}{n} \mathbf{1}\]其中$\mathbf{1}$是全1向量。
这也可以写成:
\[\mathbf{r} = \left(d \mathbf{A} + \frac{1-d}{n} \mathbf{E}\right) \mathbf{r}\]其中$\mathbf{E}$是全1矩阵。
四、PageRank计算方法
4.1 幂法(Power Method)
由于PageRank向量是矩阵$\left(d \mathbf{A} + \frac{1-d}{n} \mathbf{E}\right)$对应于特征值1的特征向量,可以通过幂法来求解。
算法步骤:
- 初始化:设$\mathbf{r}^{(0)} = \frac{1}{n} \mathbf{1}$
-
迭代更新:对于$t = 0, 1, 2, \ldots$
\[\mathbf{r}^{(t+1)} = d \mathbf{A} \mathbf{r}^{(t)} + \frac{1-d}{n} \mathbf{1}\] - 收敛判断:当$|\mathbf{r}^{(t+1)} - \mathbf{r}^{(t)}| < \epsilon$时停止迭代($\epsilon$为一个小正数,如$10^{-6}$)。
4.2 收敛性分析
根据Perron-Frobenius定理,对于正矩阵(所有元素为正),存在唯一的最大特征值(为正),对应的特征向量所有分量均为正。
在PageRank中,由于添加了随机跳转项$\frac{1-d}{n}$,使得原本可能不连通或周期性的马尔可夫链变为不可约、非周期的正矩阵,从而保证了:
- 存在唯一的平稳分布
- 幂法能够收敛到该分布
4.3 计算复杂度与优化
直接计算矩阵乘法的时间复杂度为$O(n^2)$,对于大规模网络不可行。实际应用中采用稀疏矩阵技术,只存储和计算非零元素,时间复杂度降为$O(L)$,其中$L$是链接总数。
五、PageRank的扩展与改进
5.1 Personalized PageRank
个性化PageRank允许为不同用户或主题定制不同的随机跳转概率分布:
\[\mathbf{r} = d \mathbf{A} \mathbf{r} + (1-d) \mathbf{v}\]其中$\mathbf{v}$是个性化的跳转向量。
5.2 Topic-Sensitive PageRank
针对不同主题分别计算PageRank值,提高搜索结果的相关性。
参考文献
[1] PageRank Algorithm - Stanford University [2] The PageRank Citation Ranking: Bringing Order to the Web [3] Markov Chains and Mixing Times
注:本文使用Qwen转换自本人的统计学习方法笔记。