Shihanmax
九、EM算法:期望最大化(Expectation Maximization)
引入:三硬币模型
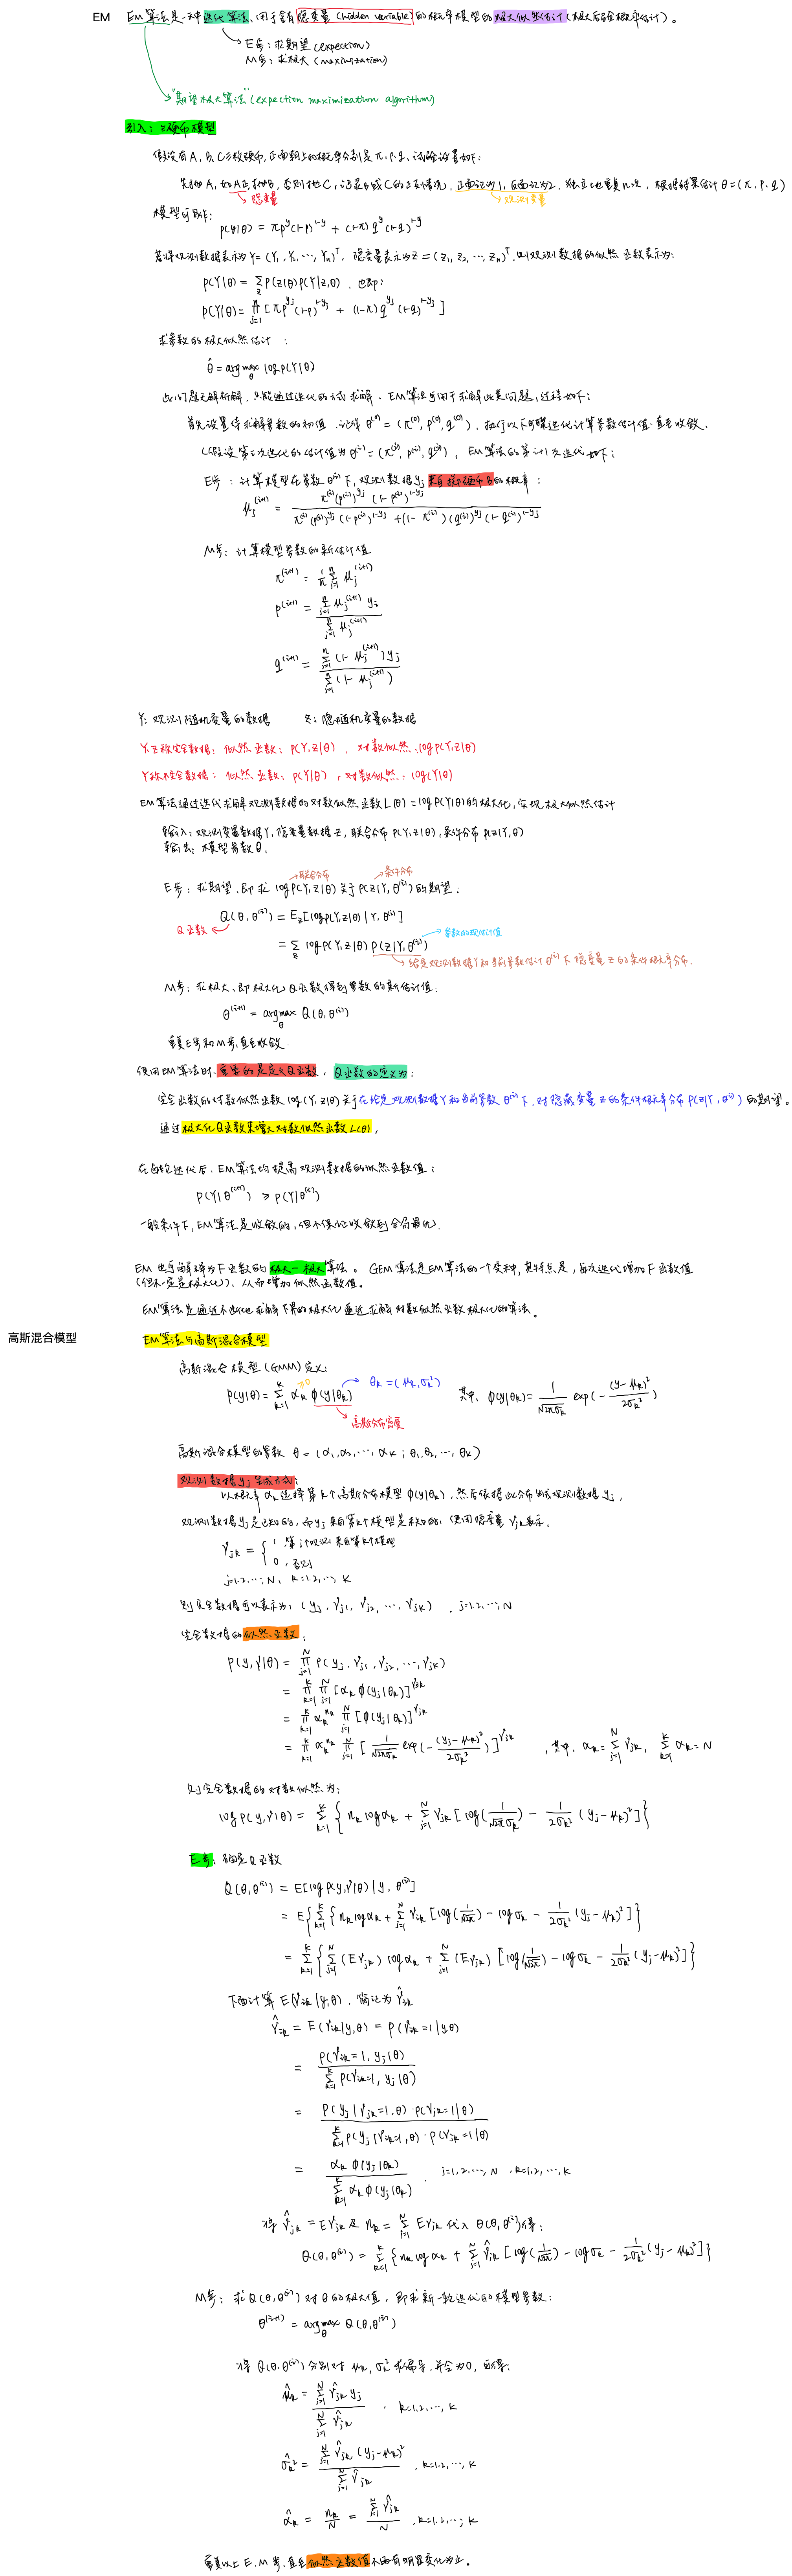
假设有A、B、C三枚硬币,正面朝上的概率分别是$\pi$、$p$、$q$。试验设置如下:
- 先抛掷硬币A,如果A正面朝上,则抛掷B;否则抛掷C。
- 记录B或C的结果(正面记为1,反面记为0)。
- 独立重复$N$次,根据结果得到观测数据$\theta=(z_1, z_2, \ldots, z_n)$。
隐变量
设隐变量表示为$Z=(z_1, z_2, \ldots, z_n)$,则观测数据的似然函数表示为:
\[P(Y|\theta) = \prod_{i=1}^{n} [ \pi P(z_i|p) + (1-\pi) Q(z_i|q) ]\]求极大似然估计
\(\hat{\theta} = \arg\max_{\theta} \log P(Y|\theta)\)
问题解析
EM算法可用于求解此类问题,过程如下:
-
初始化:设置参数初始值,记作$\theta^{(0)}=(\pi^{(0)}, p^{(0)}, q^{(0)})$。通常以下的迭代优化计算数值稳定且收敛。
-
E步:计算第m次迭代的估计值$\theta^{(m)}=(\pi^{(m)}, p^{(m)}, q^{(m)})$。
- 对于每个样本yᵢ,计算其属于B的概率: \(y_{ij}^{(m)} = \frac{\pi^{(m)}(p^{(m)})^j(1-p^{(m)})^{5-j}}{\pi^{(m)}(p^{(m)})^j(1-p^{(m)})^{5-j} + (1-\pi^{(m)})(q^{(m)})^j(1-q^{(m)})^{5-j}}\)
-
M步:计算模型参数的新估计值。
-
$\pi$的估计: \(\pi^{(m+1)} = \frac{1}{n} \sum_{i=1}^{n} y_{ij}^{(m)}\)
-
$p$的估计: \(p^{(m+1)} = \frac{\sum_{i=1}^{n} j y_{ij}^{(m)}}{\sum_{i=1}^{n} 5 y_{ij}^{(m)}}\)
-
$q$的估计: \(q^{(m+1)} = \frac{\sum_{i=1}^{n} j (1-y_{ij}^{(m)})}{\sum_{i=1}^{n} 5 (1-y_{ij}^{(m)})}\)
-
符号说明
- Y: 观测随机变量数据
- Z: 隐随机变量数据
- $\theta$: 参数向量,$\theta=(\pi, p, q)$
EM算法
输入
-
观测数据集 $Y$,隐变量集 $Z$,联合分布 $P(Y,Z \theta)$ -
条件分布 $P(Z Y,\theta)$ - 输出:参数 $\theta$
E步:求期望
即求 $Q(\theta|\theta^{(i)})$ 关于 $P(Z|Y,\theta^{(i)})$ 的期望; \(Q(\theta|\theta^{(i)}) = \sum_{Z} \log P(Y,Z|\theta) P(Z|Y,\theta^{(i)})\) 给定观测数据 $Y$ 和当前参数估计 $\theta^{(i)}$ 不变,最大化 $Q$ 的条件概率分布 $P(Z|Y,\theta^{(i)})$ 的期望值。
M步:求极大似然估计
$\theta^{(i+1)}$,即极大化 $Q(\theta|\theta^{(i)})$ \(\theta^{(i+1)} = \arg\max_{\theta} Q(\theta|\theta^{(i)})\)
收敛性
-
定义函数的对数似然函数 $\log L(\theta Y,Z)$ 关于在给定观测数据 $Y$ 和当前参数 $\theta^{(i)}$ 下,对隐藏变量 $Z$ 的条件概率分布 $P(Z Y,\theta^{(i)})$ 的期望。 - 在迭代运行后,EM算法均是提高观测数据集的似然函数值(但不保证最大值),从而增加似然函数值。
一般条件下,EM算法是收敛的,但不保证收敛到全局最优。
EM算法也解释为下凸函数的极大极小化,其本质是一个优化过程,通过迭代优化参数值(但不保证最大值),从而增加似然函数值。
高斯混合模型
概率密度函数
\(P(Y|\theta) = \sum_{k=1}^{K} \alpha_k \phi(Y|\theta_k)\) 其中, \(\phi(Y|\theta_k) = \frac{1}{N\sqrt{2\pi}\sigma_k} \exp\left(-\frac{(Y-\mu_k)^2}{2\sigma_k^2}\right)\)
参数
- $\theta = (\alpha_1, \ldots, \alpha_K; \theta_1, \ldots, \theta_K)$
观测数据生成
以概率 $\alpha_k$ 选择第 $k$ 个高斯分布 $\phi(Y|\theta_k)$,然后依据此分布生成观测数据 $Y$。
EM算法与高斯混合模型
高斯混合模型的生成过程
观测数据生成过程:
-
以概率 $\alpha_k$ 选择第 $k$ 个高斯分布模型 $\phi(y_i \theta_k)$,然后依据此分布生成观测数据 $y_{ik}$。 -
则真实数据可以表示为:$(y_i, y_{i1}, y_{i2}, …, y_{ik})$,其中 $i=1,2,…,N$。
-
完全数据的对数似然函数为: \(\log P(Y, Y^*|\theta) = \sum_{i=1}^{N} \prod_{k=1}^{K} [p(y_i|\theta_k)\phi(y_{ik}|\theta_k)]^{y_{ik}}\) \(= \sum_{k=1}^{K} \alpha_k^n \prod_{i=1}^{N} \left[\frac{1}{\sqrt{2\pi}\sigma_k} \exp\left(-\frac{(y_i-\mu_k)^2}{2\sigma_k^2}\right)\right]^{y_{ik}}\) 其中,$\alpha_k = \sum_{i=1}^{N} p_{ik}$,$\sum_{k=1}^{K} \alpha_k = N$
- 下面计算 $E(Y_{ik}|Y,\theta)$,简记为 $\hat{Y}_{ik}$: \(\hat{Y}_{ik} = E(Y_{ik}|Y,\theta)\) \(= \frac{P(Y_{ik}=1,y_i|\theta)}{P(Y_{ik}=1|\theta)}\) \(= \frac{P(y_i|Y_{ik}=1,\theta) \cdot P(Y_{ik}=1|\theta)}{P(Y_{ik}=1|\theta)}\) \(= \frac{\alpha_k \phi(y_i|\theta_k)}{\sum_{k=1}^{K} \alpha_k \phi(y_i|\theta_k)} \quad i=1,2,...,N; \quad k=1,2,...,K\)
随机变量的对数似然函数
\[\log L(\theta, \theta^0) = \sum_{i=1}^{N} \left[ \frac{1}{2} \log \sigma_k^2 - \frac{1}{2\sigma_k^2} (y_i - \mu_k)^2 \right]\] \[Q(\theta, \theta^0) = E[\log L(\theta, \theta^0)]\] \[= E \sum_{i=1}^{N} \left[ \frac{1}{2} \log \sigma_k^2 + \frac{1}{2\sigma_k^2} \left[ \log \left( \frac{1}{\sqrt{2\pi}} \right) - \frac{1}{2\sigma_k^2} (y_i - \mu_k)^2 \right] \right]\] \[= \sum_{i=1}^{N} \left[ \frac{1}{2} \sum_{j=1}^{k} \frac{1}{\sigma_k} (E Y_{jk}) \left[ \log \left( \frac{1}{\sqrt{2\pi}} \right) - \frac{1}{2\sigma_k^2} (y_i - \mu_k)^2 \right] \right]\] \[\hat{\gamma}_{ik} = E(Y_{ik} | \theta) = P(Y_{ik} = 1 | \theta)\] \[= P(y_i | Y_{ik} = 1, \theta) \cdot P(Y_{ik} = 1 | \theta)\] \[= \frac{\lambda_k \phi(y_i | \theta)}{\sum_{l=1}^{K} \lambda_l \phi(y_i | \theta)}, \quad i = 1, \ldots, N; \quad k = 1, \ldots, K\]M步
求 $Q(\theta, \theta^0)$ 对 $\theta$ 的极大值,即求新迭代过程的模型参数:
\[\hat{\mu}_k^* = \frac{\sum_{i=1}^{N} \hat{\gamma}_{ik} y_i}{\sum_{i=1}^{N} \hat{\gamma}_{ik}}, \quad k = 1, 2, \ldots, K\] \[\hat{\sigma}_k^{*2} = \frac{\sum_{i=1}^{N} \hat{\gamma}_{ik} (y_i - \hat{\mu}_k^*)^2}{\sum_{i=1}^{N} \hat{\gamma}_{ik}}, \quad k = 1, 2, \ldots, K\] \[\hat{\lambda}_k = \frac{\sum_{i=1}^{N} \hat{\gamma}_{ik}}{N}, \quad k = 1, 2, \ldots, K\]重复以上E、M步,直到求得的模型参数值不会有明显变化为止。
总结
EM算法是一种强大的工具,用于处理含有隐变量的统计模型。在高斯混合模型中,EM算法能够有效地估计模型参数,但在实际应用中需要注意:
- 初始参数的选择对结果有较大影响
- 可能陷入局部最优解
- 需要适当设置停止条件
EM算法通过迭代优化参数值(但不保证最大值),从而增加似然函数值,最终达到收敛。
注:本文使用Qwen转换自本人的统计学习方法笔记。
参考文献
[1] 《统计学习方法》,李航著,清华大学出版社